大企業がAIで作成されたスライドを会議室で厳しく規制している理由
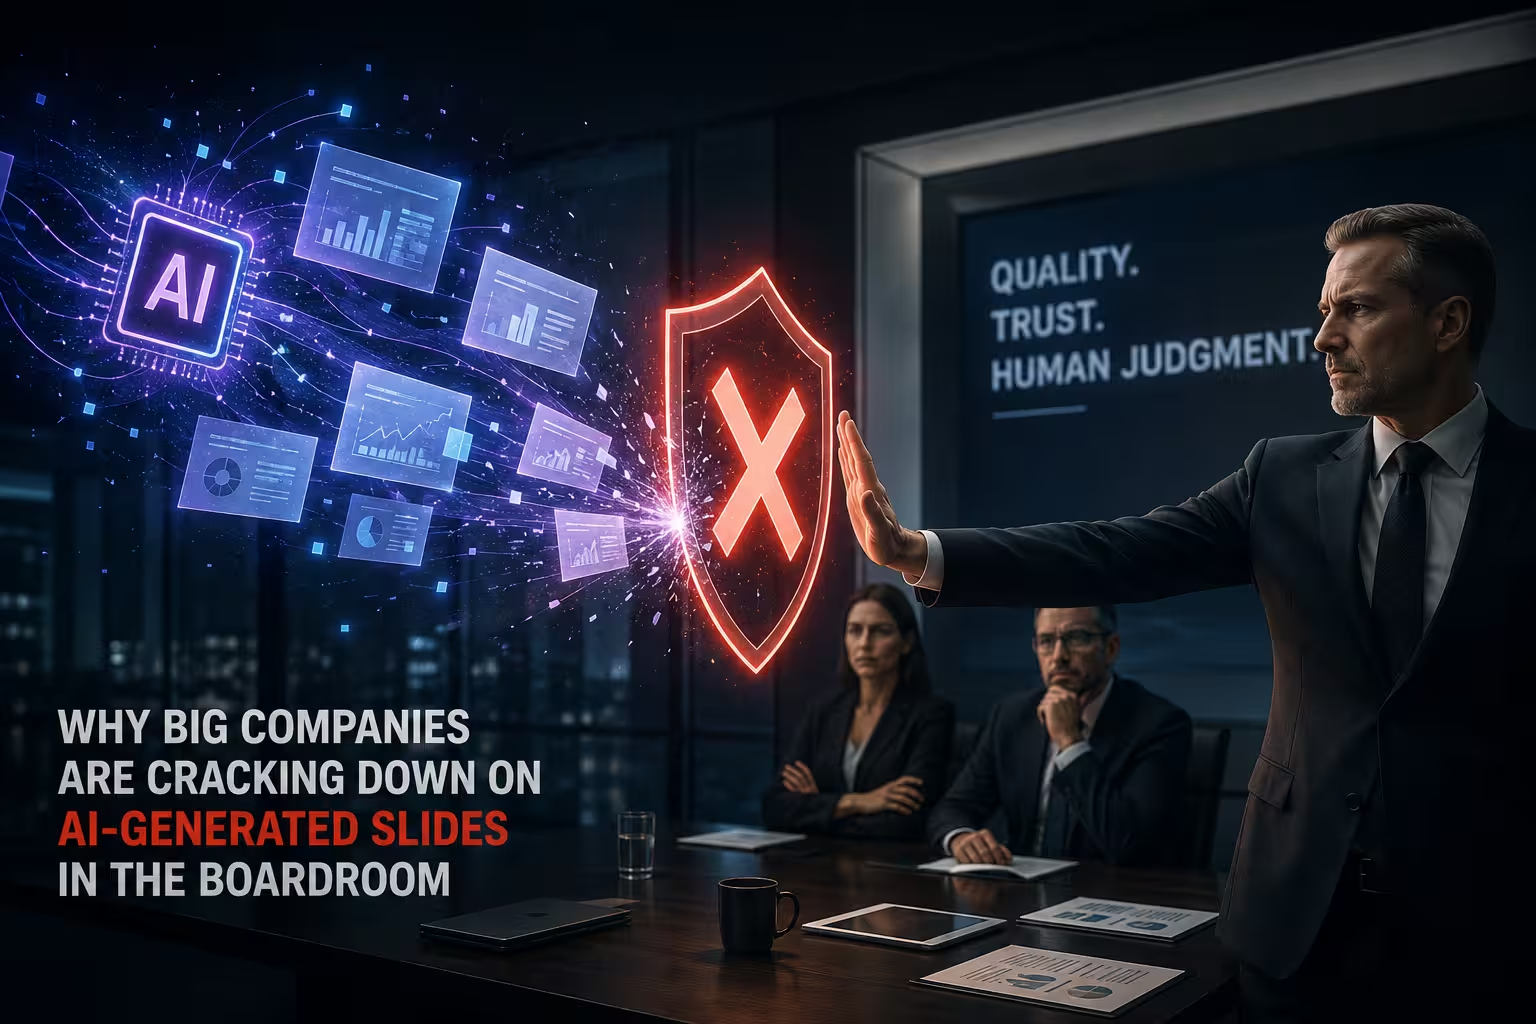
役員会議で役員が日常的な質問を投げかけることがあります:この「回転率」の数字はどこから出てきたのでしょうか。通常、誰かがソースタブを指したり、その数字を取り出したアナリストの名前を挙げます。今回は、誰も答えられませんでした——そのスライドは前夜に生成され、背後にあるクエリは消え、デッキを「作成」した人物はただ「ツールにプロンプトを貼り付けた」としか説明しません。その数字は、信憑性のある範囲内にあったため、二度目の会議でようやく見つかりました。これが、十分な数の企業で繰り返された瞬間であり、AI生成スライドが生産性の話からガバナンスの問題へと変わった瞬間です。
役員会議のデッキは、他の会社文書にはない重みを持っており、誰もがソースを指し示せないようなデッキは、その重みに耐えられません。
---
**問題はAIではなく、欠落した注釈だった**
役員会議に提出される他のどの文書も、誰かが再現可能なチェーンを経ています:財務アナリストがその数字を取得し、会計責任者がそれをレビューし、VPがフレーミングを承認します。このチェーンが、悪い数字を個人のミスにするのです。生成型ツールは、このチェーンをデフォルトで保持しません——出力は、モデルが実際の会社データを引用したか、統計的に合理的なものを組み合わせたか、または気付かないうちにギャップを埋めたかにかかわらず、同じように見えます。
NISTの2024年「Generative AI Risk Profile」では、この失敗モードに正式な名前を付けました:confabulation(架空の内容)——正しい出力と同じ自信で述べられた、間違った出力です。**これが、特に役員会議のスライドにおいて危険な部分です**。架空の顧客のテストモニアルは恥ずかしいかもしれません。しかし、内部的に一貫性のある架空の収益トレンドが、デッキの他のチャートと同じ形式で表示されると、誰もチェックする前に、実際の資本配分決定に影響を与える可能性があります。
---
**役員会議のデッキは、一度プレゼンテーションするだけでなく、数年後に読まれることを想定して作成されなければなりません**
ここが、他の形式的な会社文書との比較が役に立つポイントです。誰もがの株主向け年次報告書を作成した経験があるように、その文書は、2分でスキミングする人と、すべての注釈に徹底的に調査する人、両方を同時にサポートしなければなりません。役員会議のデッキには、これらの文書が共有しない第三の義務があります:イギリスでは、会社法第248条に基づき、役員会議および委員会の議事録は少なくとも10年間保管されなければなりません。AI生成の要約や議事録がこの会議に関連付けられている場合、その記録の一部として扱われるリスクがあります。誰もがソースに遡れないスライドは、ただただその場で不細工に見えるだけでなく、10年間ファイルに保管されたままの責任を負うことになります。
これは、「チャートはプロフェッショナルに見えるか」という非常に低い基準ではありません。「このスライドが5年後に紛争で引き合いに出されて検証されることを想定して作成されているか」という基準です——そして、ソースのオーディットトレイルのないAI生成数字は、一般的にその基準を満たしません。
---
**正直さの問題もあり、これは少し逆説的です**
AIツールに抵抗があると考えると、純粋に正確性の問題だと思いますが、そうではありません。2024年のGC100(FTSE 100および250の一般法務担当者を代表する団体)による世論調査では、多くの役員が、AIツールが役員会議の議論を録音または要約することに不安を抱いていることがわかりました。これは、事実誤認の懸念とは別に、心理的な問題です:すべての言葉が録音され分析されるかもしれないと知ると、役員会議で人がどのように開かれた議論をするかが変わります。役員会議は、会社の他の場所では起こらない率直な議論を行うための場の一部です。ツールがその議論を静かにログに記録すること(正確であっても)は、それを平坦化させる可能性があります。
そのため、制限は「AIが間違いを犯した」というものだけではありません。ときには「AIの存在が、人が会議で言えることを変えた」という問題もあり、これは単にプロンプトを改善するだけでは解決できない難しい問題です。
---
**これは、このようなツールを急速に制限する企業が初めてではありません**
このパターンには、会社の別の領域で先例があります。2023年、サムスンは、半導体部門のエンジニアが3週間以内に3件の別々の事案で、秘密のソースコードと内部会議のメモを公開チャットボットに漏洩させた後、社内のデバイスで生成型AIツールの使用を禁止しました。この禁止は、AIカテゴリー全体を拒否するものではありませんでした——特定の、追跡可能な失敗モードに対するリーダー層の判断によるものです。役員レベルでのAI生成スライドの制限も、同様の形を取っています:AI全面禁止ではなく、追跡不可能な出力が実際の損害をもたらす可能性のある特定のポイントに焦点を当てた規則です。
この問題が複雑になるのは、人が最初に考える解決策(「ただAIの数字を誰かが二度チェックすればいい」というもの)が、チェッカーに時間と元のソースデータが残っていることを前提としています。実際には、デッキが役員会議に届く頃には、最終レビューを行う人は、ほとんどの場合、ナラティブの流れとフォーマットを最適化しており、数字をゼロから再計算するのではなく、数字を確認するステップが、締め切りの圧力で最初に省略されることが多いのです。
---
**実際に制限されているのは何で、制限されていないのは何か**
ほとんどの企業が、AIをプレゼンテーション作業全体で禁止することはありません——これは、フォーマット、初稿、デザインの反復においてツールが実際に時間を節約することを考えると、奇妙な戦いを選ぶことになります。制限されているのは、はるかに具体的なものです:役員会議のスライドに人間が検証可能なソースなしで到達する**AI生成の数字と主張**です。デザインの助言、レイアウトの提案、言語の整形はほとんど制限されていません。問題になっているのは、データ層です。
この区別は、生成型AIが登場する以前から、コンサルティングデッキが長年強調してきたものとほぼ完全に一致します。のマッキンゼースタイルのスライド構築の原則は、すべてのタイトルが検証可能な主張を述べ、すべてのチャートにソースラインが付くことを要求しています——これは、フォーマットルールではなく、ソースのない数字は未完成の分析と見なされ、実質的な分析とは見なされないという基準です。ソースを引用できない生成型ツールは、1995年に未ソースのチャートを失敗させたジュニアアナリストと同じように、このテストに失敗します。ツールは変わりましたが、役員が実際に適用する基準は変わりませんでした。
---
**テンプレートの下にある仕組みは、想像以上に重要です**
今、役員会議のデッキプロセスを再構築している人に伝えたいことがあります:チャートの形式自体が、追跡可能性をサポートするか、それを崩すかを決定する可能性があります。の構造化されたチャートレイアウトで、固定されたソースラインフィールドを備えていると、ソースの記載を省略するのは難しくなります——空のフィールドが目立つからです。AIツールの出力から直接貼り付けたチャートは、通常、そのようなラインのための場所を備えていないため、その習慣が滑り込む理由の一部です。人々が到達するポリシー的な解決策は手続き的なもの(「AIの出力を役員会議に届く前にレビューする」)ですが、レイアウト自体が、ポリシー文書だけでは行えない静かな強制を行っています。
これらすべてがAIが役員会議から去ることを意味するわけではありません——それは、実際に有用なドラフトやフォーマットの作成に押し戻されるだけです。一方で、実質的な意思決定に影響を与える数字は、誰かが名前を付けられるソースに遡らされます。多くの企業にとって、より難しい質問は、「AIが役員会議のデッキに近づくことを許可するかどうか」ではなく、「現在のレビュープロセスが、追跡不可能な数字が記載されたスライドを会議室に届く前に見つけることができたのか、それとも今回だけ偶然見つかったのか」です。
コメント (0)